AI 솔루션 문의하기


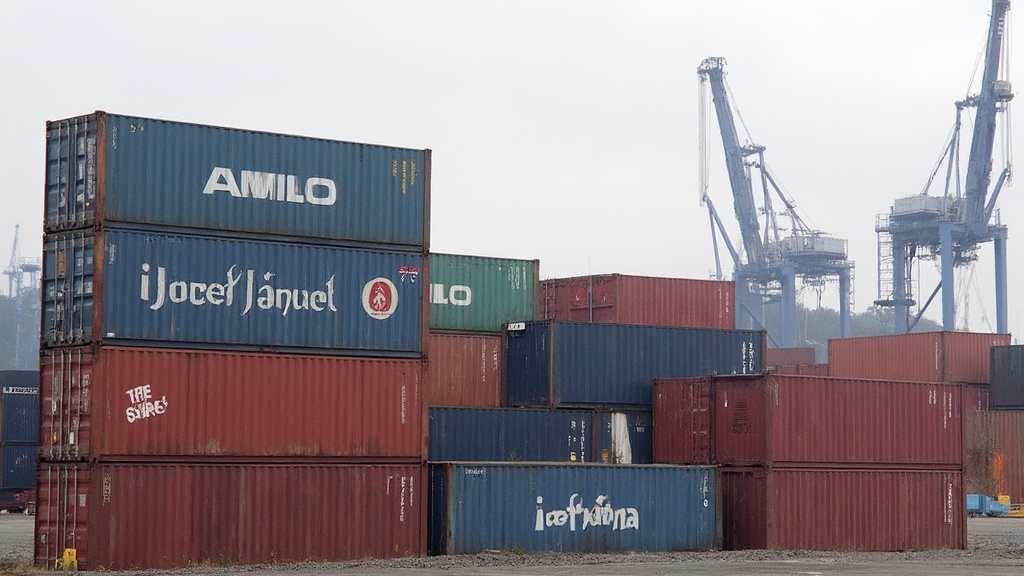
항만에서 컨테이너를 인식하는 비전 AI는 화면에 컨테이너가 있는지를 찾는 것만으로는 실제 업무에 활용하기 어렵습니다. 컨테이너에는 식별번호, 규격, 적재 방향, 상태 등 여러 정보가 함께 존재하며 주변 컨테이너와의 관계도 중요한 판단 기준이 되기 때문입니다. 같은 크기의 컨테이너라도 번호가 가려졌거나 일부만 촬영된 경우에는 인식 결과의 활용도가 달라질 수 있습니다. 따라서 데이터 구축 단계에서 단순 객체 검출과 문자 인식을 구분하면서도 필요한 경우 두 정보를 하나의 컨테이너 단위로 연결하는 구조를 설계해야 합니다.
항만 컨테이너 영상에서는 외부에 표시된 문자와 숫자를 읽어야 하는 경우가 많습니다. 하지만 컨테이너 표면은 깨끗한 상태로만 유지되지 않으며 도색 벗겨짐, 오염, 녹, 반사광 등으로 인해 식별번호의 일부가 흐릿하게 보이는 사례도 나타납니다. 또한 번호가 컨테이너의 어느 면에 표시됐는지에 따라 카메라의 촬영각도도 달라집니다. 이에 따라 데이터셋에는 선명하게 촬영된 번호뿐 아니라 일부 문자가 가려지거나 훼손된 사례도 포함할 필요가 있습니다. 문자 영역과 컨테이너 영역을 별도로 라벨링하면 객체탐지와 OCR 학습에 각각 활용하기도 수월합니다.
컨테이너 터미널에서는 컨테이너가 단독으로 놓이는 경우보다 여러 개가 일정한 형태로 적재되는 장면이 많습니다. 이 때문에 개별 컨테이너의 위치뿐 아니라 어느 적재열에 속해 있는지, 앞뒤 또는 상하로 어떤 컨테이너가 배치돼 있는지도 데이터 활용 과정에서 의미를 가질 수 있습니다. 특히 위에서 내려다보는 영상과 지상에서 촬영하는 영상은 같은 적재 상태를 서로 다르게 표현합니다. 데이터 구축 시 컨테이너별 위치 정보를 일관되게 기록하고 촬영 시점에 따라 동일한 컨테이너가 어떻게 보이는지도 함께 관리하면 다양한 인식 업무에 활용할 수 있습니다.

컨테이너 터미널에서는 컨테이너가 고정된 상태로만 촬영되지 않습니다. 하역 과정에서 크레인이나 운송장비가 컨테이너를 이동시키면서 같은 컨테이너의 위치와 화면 내 크기가 계속 변하는 상황이 발생합니다. 컨테이너가 들어 올려지거나 내려오는 과정에서 다른 구조물에 일부 가려질 수도 있습니다. 따라서 데이터 구축에서는 정지된 적재 상태의 이미지뿐 아니라 이동 중인 컨테이너가 등장하는 영상도 함께 고려해야 합니다. 특히 영상 데이터를 프레임 단위로 나눌 경우 동일 장면이 과도하게 반복되지 않도록 장면 변화가 발생하는 구간을 중심으로 데이터를 선별하는 작업이 필요합니다.
컨테이너 외관은 사용 기간과 운송 환경에 따라 다양한 상태를 보입니다. 표면의 긁힘이나 찌그러짐, 녹, 도색 변화 등이 나타날 수 있으며 이런 흔적이 단순한 사용 흔적인지 점검이 필요한 손상인지는 별도의 기준이 필요합니다. 인식 데이터와 상태판단 데이터를 하나의 라벨로 묶기보다 컨테이너 식별과 외관 상태를 별도의 속성으로 관리하는 방식이 적합합니다. 이렇게 구성하면 동일한 컨테이너 이미지가 번호 인식, 객체 검출, 외관 점검 등 서로 다른 AI 학습 목적에 활용될 수 있습니다.
항만은 24시간 운영되는 시설이 많기 때문에 주간 영상만으로 실제 환경을 충분히 구성하기 어렵습니다. 야간 조명 아래에서는 컨테이너의 표면이 어둡게 보이거나 특정 부분에 강한 반사광이 발생할 수 있고, 비나 안개가 끼면 식별번호와 컨테이너 윤곽이 동시에 흐려지는 상황도 나타납니다. 따라서 데이터셋을 구축할 때 시간대와 날씨를 함께 관리하고 조건별 데이터가 어느 정도 포함돼 있는지 확인해야 합니다. 특정 조명 환경에서만 촬영된 데이터가 지나치게 많으면 다른 시간대의 영상에서 인식 성능이 달라질 수 있습니다.
컨테이너를 촬영하는 카메라의 위치도 데이터 구성에 큰 영향을 줍니다. 게이트를 통과하는 차량을 촬영하는 카메라와 야드 전체를 내려다보는 카메라는 같은 컨테이너를 전혀 다른 형태로 담습니다. 정면에 가까운 영상에서는 식별번호를 읽기 쉽지만 원거리나 비스듬한 각도에서는 문자 영역이 작아질 수 있습니다. 따라서 데이터 수집 단계에서 카메라 위치를 하나로 고정하기보다 실제 운영 과정에서 사용될 여러 시점을 반영하는 것이 필요합니다. 카메라별 데이터를 구분해 관리하면 특정 촬영 위치에 편중된 데이터셋을 방지하는 데에도 도움이 됩니다.
컨테이너 영상만 따로 모으는 것보다 촬영 당시의 운영정보를 함께 연결하면 데이터 활용 범위를 넓힐 수 있습니다. 예를 들어 촬영 시간과 장소, 컨테이너 식별번호, 적재 위치 등의 정보를 영상과 연결해두면 동일 객체가 이동하는 과정을 추적하거나 인식 결과를 검증하는 데 활용할 수 있습니다. 다만 실제 운영정보를 학습데이터에 포함할 때는 어떤 정보가 모델 학습에 필요한지 구분해야 합니다. 모델이 영상 자체의 특징을 학습해야 하는 작업이라면 불필요한 메타데이터가 결과에 영향을 주지 않도록 학습용 정보와 관리용 정보를 분리하는 것이 좋습니다.
항만 컨테이너 비전 AI 데이터는 하나의 거대한 이미지 묶음으로 만드는 것보다 번호 인식, 위치 파악, 적재 상태 확인, 외관 점검 등 활용 목적에 따라 필요한 라벨을 구분하는 방식이 효율적입니다. 모든 이미지에 모든 정보를 표시하면 구축 비용이 커지는 반면 실제로 사용하지 않는 라벨까지 관리해야 하는 부담이 생깁니다. 반대로 객체 영역만 필요한 작업에 문자 정보까지 요구하면 불필요한 라벨링 시간이 늘어날 수 있습니다. 먼저 현장에서 해결하려는 업무를 구체적으로 나눈 뒤 그 업무에 필요한 정보만 단계적으로 라벨링하는 방식으로 데이터셋을 구성하는 것이 실질적인 활용성을 높이는 데 도움이 됩니다.